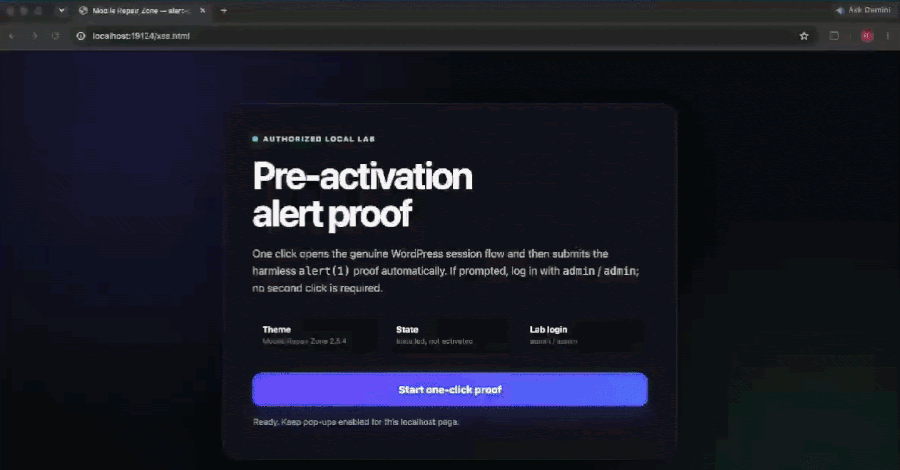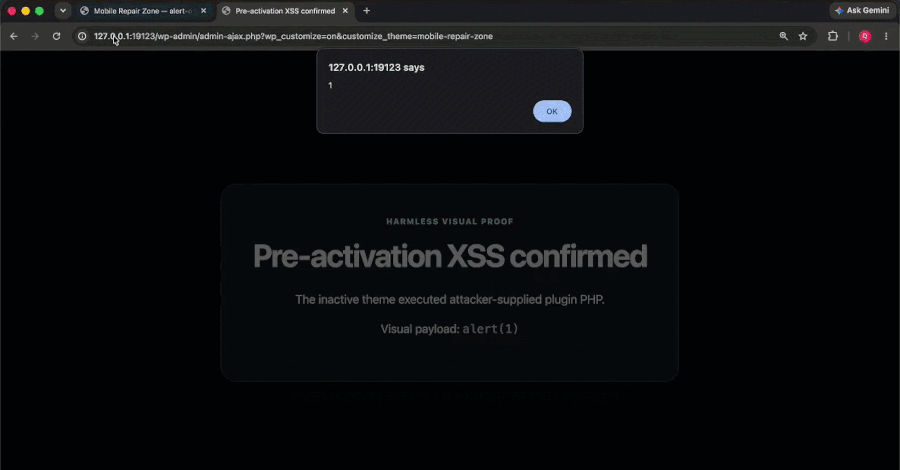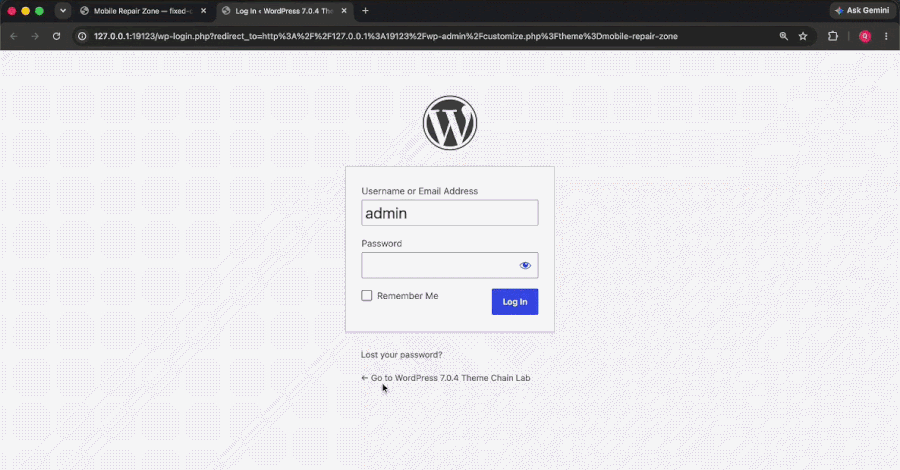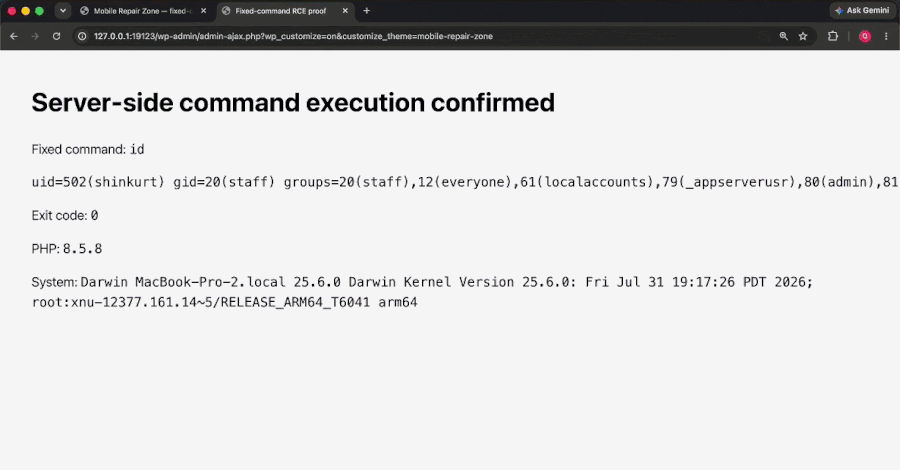
Três pesquisadores da empresa de segurança Hacktron usaram o Claude Opus 5, da Anthropic, para encadear duas falhas e assumir as contas de ChatGPT e Codex de vários funcionários da OpenAI, chegando em seguida a um repositório interno de código da empresa.
A cadeia começou por um bug no software que roda o fórum público de ajuda da OpenAI e avançou por uma fragilidade no próprio sistema de login da OpenAI.
Tratou-se de pesquisa de segurança, e não de um ataque real: a equipe comunicou as falhas à OpenAI, comprovou o acesso com um pull request (solicitação de envio de código) inofensivo e então parou. Desde a primeira análise, esse acesso interno levou menos de 72 horas.
A OpenAI confirmou a correção cerca de 14 horas após o relatório, segundo a Hacktron, e em 1º de setembro pagou à equipe uma recompensa (bounty) de US$ 6.500. A OpenAI afirmou que o prêmio "reconhece a descoberta do lado da OpenAI, e não as ações contra o Discourse", o software de código aberto que roda o fórum. Testar o próprio fórum estava fora do programa de recompensa por bugs (bug bounty).
A OpenAI não descreveu publicamente a falha de login e confirmou a descoberta por meio dessa correção e do pagamento, em vez de detalhar as invasões de contas.
A Hacktron, que se descreve como uma empresa de pesquisa de segurança assistida por IA, foi cuidadosa com o que fez e com o que deixou de fazer. Quando o link do Codex de um funcionário para o código da OpenAI no GitHub foi aberto, isso disparou um único pull request no repositório interno. A equipe não leu código-fonte, não mesclou nem publicou nada, e não tocou em dados de clientes.
O que a cadeia poderia ter alcançado era muito maior. Como os funcionários conectam outros serviços ao ChatGPT e ao Codex, a equipe afirmou que o mesmo acesso poderia, em tese, ter se estendido a ferramentas como GitHub, Slack e e-mail. Esse alcance mais amplo era possível, mas não foi usado.
Por que um bug em fórum alcançou contas de funcionários
O motivo pelo qual um bug em um fórum público pôde alcançar contas de funcionários está no sistema de login da OpenAI, e não no software do fórum. O fórum da OpenAI oferece a opção "Entrar com OpenAI", o mesmo login único (SSO, na sigla em inglês) que os funcionários usam em outros lugares.
Uma vez que os pesquisadores assumiram o controle do servidor do fórum, o login compartilhado lhes permitiu tomar as contas de ChatGPT e Codex de membros do fórum que trabalhavam na OpenAI. As vítimas não precisaram fazer nada.
A Hacktron afirmou que se tratava de um problema de identidade da OpenAI, e não de uma falha no software do fórum: qualquer serviço de terceiros ou próprio que usasse o mesmo login poderia ter concedido o mesmo acesso.
A porta de entrada foi um bug de imagem. O fórum roda em Discourse, e o Discourse repassa imagens HEIC e HEIF enviadas para uma ferramenta chamada ImageMagick, que usa a biblioteca libheif para lê-las. Uma falha na libheif permitiu que uma imagem especialmente criada corrompesse a memória do servidor do fórum.
O aviso do Discourse classifica o resultado como execução remota de código (RCE), atribui nota 8,8 de 10 e o rastreia como o identificador CVE-2026-32882 (código público de vulnerabilidades e exposições comuns). O registro público da falha em si é mais restrito. No aviso da própria libheif e em bases nacionais de vulnerabilidades, o CVE-2026-32882 aparece como uma leitura fora dos limites (out-of-bounds read) capaz de travar o software ou vazar memória adjacente, e não como um bug direto de execução de código.
A memória vazada ajuda a derrotar uma proteção comum chamada ASLR (aleatorização do espaço de endereços, uma técnica de defesa de memória). Os pesquisadores dizem ter combinado os bugs de memória da libheif, com a ajuda da IA, para transformar a falha em execução de código funcional no servidor do fórum. No projeto original (upstream), a falha foi corrigida na libheif 1.22.0 em maio de 2026.
Essa correção já existia meses antes do teste. Mas a imagem do servidor do fórum, construída sobre a distribuição Linux Debian 12, ainda vinha com a libheif antiga e sem patch, versão 1.19.7, quando os pesquisadores analisaram em julho. A correção e seu CVE já eram públicos, mas o Debian ainda não os havia incluído na versão empacotada que o fórum utilizava.
Se você administra seu próprio servidor Discourse, essa parte afeta você diretamente. Reconstrua na imagem mais recente para obter a libheif corrigida, porque apenas uma atualização da interface web pode não substituir a biblioteca antiga. Sites hospedados pelo Discourse já tinham sido corrigidos, e as versões auto-hospedadas (self-hosted) corrigidas são 2026.7.0, 2026.6.1, 2026.5.2 e 2026.1.6.
Como os pesquisadores usaram IA
Os pesquisadores usaram IA para fazer a parte difícil. Primeiro tentaram o Claude Opus 4.8, que teve dificuldades ao longo de várias sessões para montar um exploit (código de exploração) funcional depois que uma defesa padrão de memória, o ASLR, foi ativada.
A Anthropic lançou seu próximo modelo, o Claude Opus 5, na noite de 24 de julho, e em uma sessão nova ele produziu um exploit funcional em poucas horas.
O Opus 5 foi entregue com salvaguardas pensadas para impedir que ele escrevesse código de exploit para alvos reais. Os pesquisadores contornaram essas barreiras apontando o modelo para o próprio servidor de teste deles, disfarçado de alvo de prática estilo capture-the-flag (desafio simulado de segurança), e então o deixaram rodar em um loop automatizado. Mesmo assim, eles dizem que o trabalho não foi no piloto automático: a direção humana especializada ainda foi importante, e não se tratou de hacking automatizado sem ninguém no controle.
O caso se encaixa no que pesquisadores e empresas de IA descreveram neste ano: modelos de IA capazes estão reduzindo drasticamente o tempo e a habilidade que trabalhos ofensivos sérios costumavam exigir. A Anthropic relatou que grupos criminosos e patrocinados por Estados já usam seus modelos Claude para realizar invasões reais, e não apenas para responder perguntas.
A OpenAI foi um alvo dentro de um projeto mais amplo que a Hacktron chama de HEIF Heist. Ao longo de cerca de dois meses, a equipe afirma ter encontrado a mesma classe de falhas de decodificação de imagens em softwares usados por outras grandes empresas, a um custo total inferior a US$ 3.000 em uso de IA. A campanha está associada a bugs reportados em Slack, produtos da Meta, GitHub Enterprise e frameworks web como Next.js.
Essas alegações mais amplas têm sustentações irregulares. A falha no Next.js está confirmada no aviso da própria Vercel, e os mantenedores da libheif confirmaram um exploit funcional de execução de código para o bug associado à Meta. A afirmação mais ampla de execução de código em muitos aplicativos não foi confirmada de forma independente, um limite que o The Hacker News observou quando cobriu pela primeira vez a falha no Next.js, em agosto.
A campanha mais ampla usou um modelo diferente, o GPT-5.6 Sol, da própria OpenAI, para casos em que a equipe não sabia nada sobre o alvo com antecedência. Apenas uma empresa, a Shopify, parece ter notado a atividade, dizem os pesquisadores, mesmo com seus processadores de imagem travando repetidamente sob milhares de envios de teste.
O The Hacker News contatou a Hacktron com perguntas sobre como a execução de código no fórum foi alcançada e sobre o escopo do acesso às contas.
O que fazer
As lições maiores vão além do Discourse. Se o seu serviço aceita imagens de usuários e lê arquivos HEIC, HEIF ou AVIF por meio da libheif, uma versão antiga pode estar exposta.
E se um serviço público, de menor confiança, compartilha seu login único (SSO) com ferramentas internas, uma invasão nesse serviço pode se tornar uma invasão em todo lugar que o mesmo login alcança.
- Atualize a libheif para o release de segurança mais recente (1.23.4 no início de setembro de 2026) ou para a versão corrigida da sua distribuição.
- Onde não for necessário, desligue a decodificação de imagens HEIF e AVIF não confiáveis, ou execute o processamento de imagens dentro de um sandbox (ambiente isolado e restrito) bem protegido.
- Limite quais serviços seu login único (SSO) confia e exija uma nova verificação de identidade antes de ações sensíveis, em vez de confiar em uma sessão existente.
Não há sinais de que a falha da OpenAI tenha sido usada contra alguém no mundo real. Em meados de setembro de 2026, ela não estava na lista do governo dos EUA de vulnerabilidades sabidamente exploradas, embora essa lista não seja prova em nenhum dos sentidos.
O que os relatórios disponíveis não esclarecem é se uma organização que já corrigiu o problema ainda deve verificar acessos anteriores; sobre esse ponto, as fontes são silenciosas.